
Zentrales System · Verstehen und Entscheiden
Gelände, Fahrbahnunebenheiten und Fahrzeugzustand einbeziehen, um Kontext und Aufgabenziele zu verstehen und das Gesamtfahrzeug zu koordinieren.
JDO / EMBODIED INTELLIGENCE TECHNOLOGY
Das JDO AI-Gesamtsystem ist ein Embodied-Intelligence-Kern für Fahrzeuge und Roboter.
AI-Gesamtsystem kennenlernenFür die Koordination im Gesamtfahrzeug Informationen aus Innenraum, Umgebung und Fahrzeugstatus zusammenführen.
Gelände, Fahrbahnunebenheiten und Fahrzeugzustand einbeziehen, um Kontext und Aufgabenziele zu verstehen und das Gesamtfahrzeug zu koordinieren.
Koordinationsabsichten übernehmen, in den jeweiligen Domänen in Echtzeit ausführen und Status zurückmelden, um weiteres Verständnis und Entscheidungen zu unterstützen.
Gemeinsame Grundlage für Fahrzeuge und Roboter, angepasst an die jeweilige Plattform
Aufgaben, Erfahrungen und langfristige Präferenzen
Den Umfang der Verarbeitung an die Aufgabe anpassen
Spätere Kontexte vorausschauend einschätzen
Grundlagen für Wahrnehmung, Verstehen und Gedächtnis bei Interaktionen und Aufgaben im Fahrzeug bereitstellen.
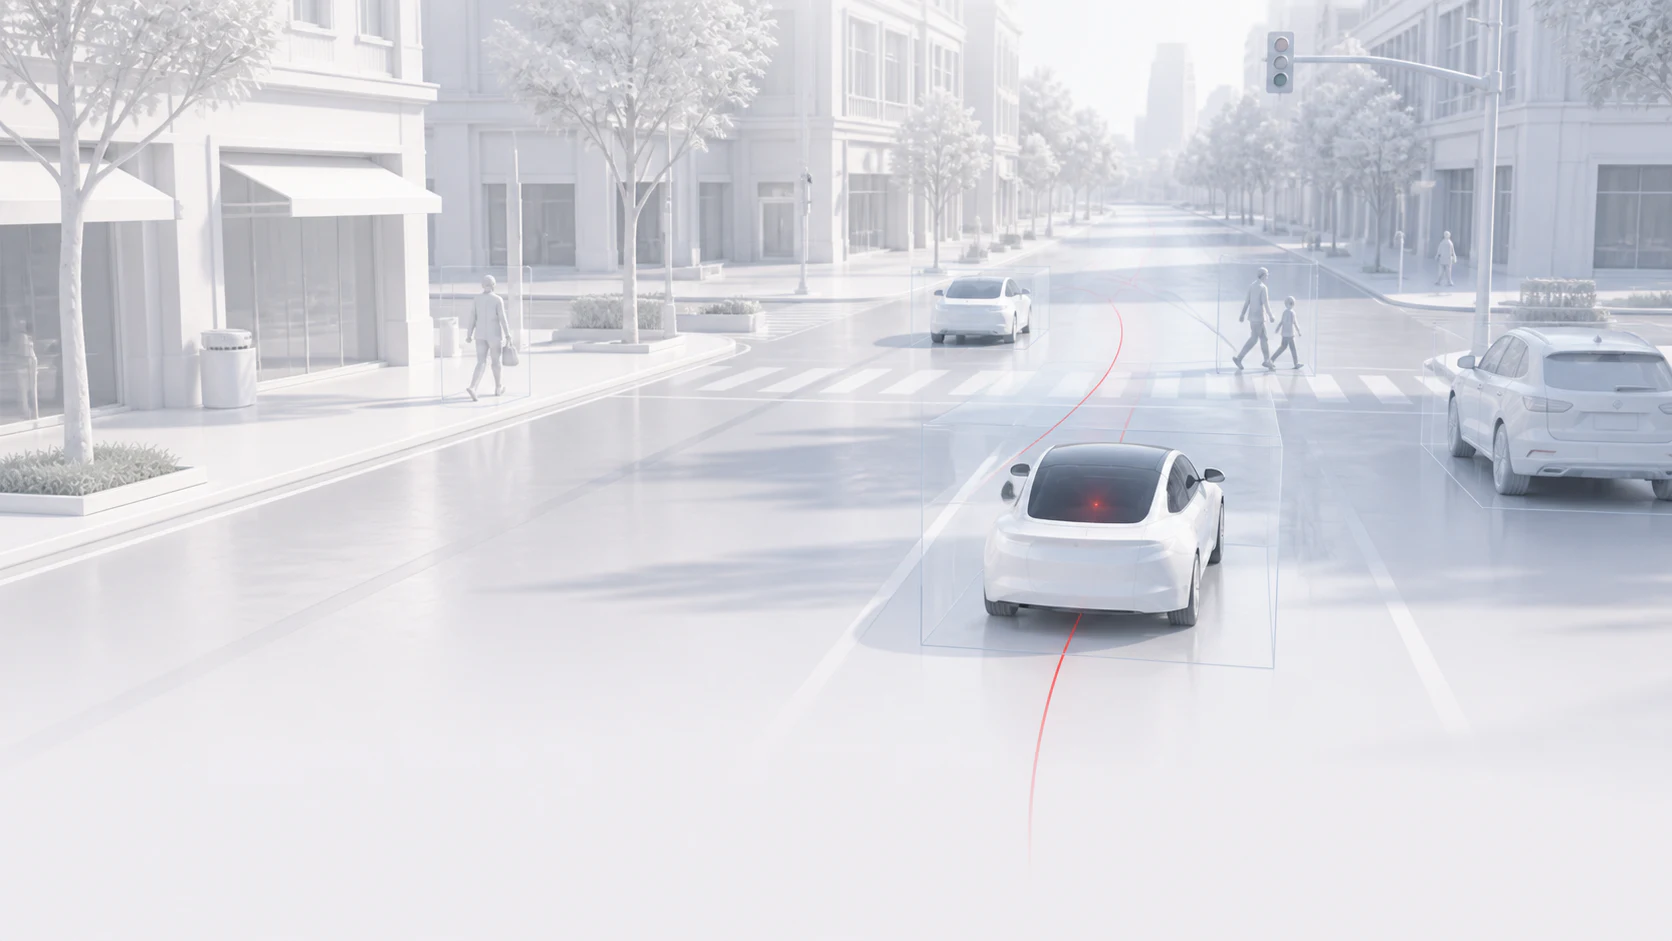
Visuelle und sprachliche Informationen verbinden, um Verkehr, Objekte, Oberflächen und Fragestellungen innerhalb und außerhalb des Cockpits zu verstehen.
Natürliche Äußerungen auch bei Fahrzeuggeräuschen, schwachem Netz und Offline-Bedingungen in den Aufgabenablauf einbinden.
Bei vorliegender Autorisierung und verfügbaren Daten unterstützt das System Einschätzungen und Hinweise, ersetzt jedoch keine medizinische Diagnose.
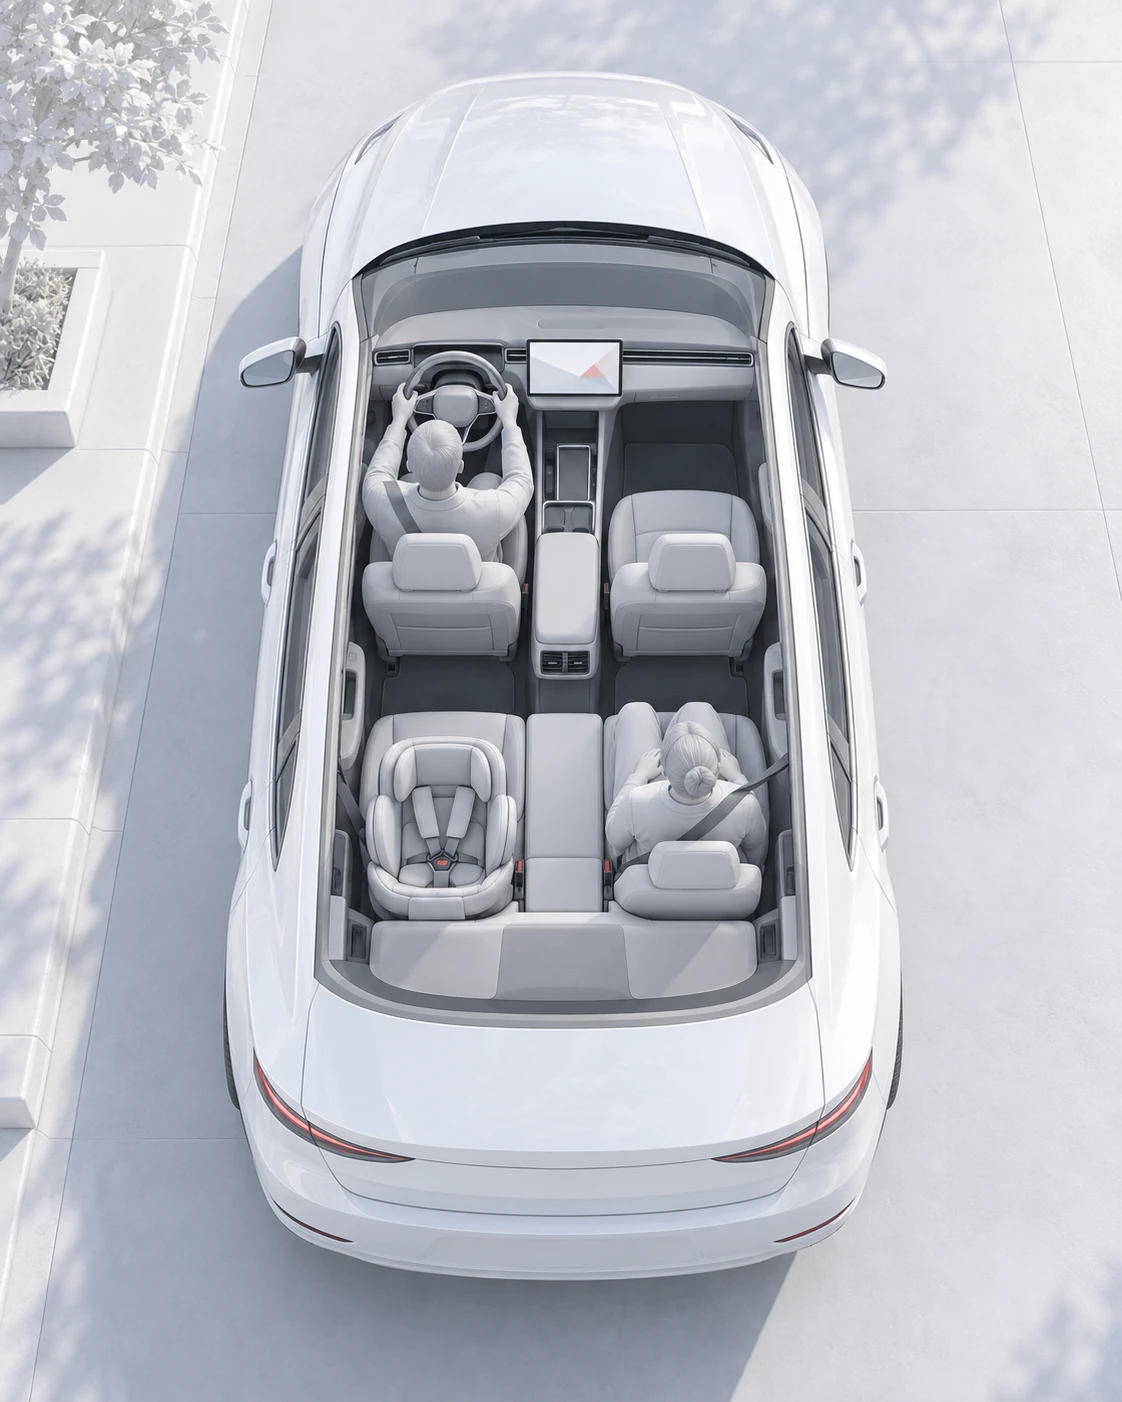
Wahrnehmungseingaben zum Zustand von Fahrer, Insassen und Kindern bereitstellen, um Hinweise, Interaktion und Dienste zu unterstützen.
Visuelle, sprachliche und akustische Informationen mit Fahrzeugstatus verknüpfen und daraus einen nutzbaren Kontext bilden.
Präferenzen und Aufgabenkontext im vom Nutzer autorisierten Umfang erhalten, damit Dienste nahtlos fortgesetzt werden können.
Modelle und Algorithmen, Laufzeitframework, Aufgabenplanung und Cloud-Anbindung unterstützen gemeinsam die Anwendungen des AI-Gesamtsystems.
Multimodale Modelle und Wahrnehmungsalgorithmen
Nutzeräußerungen mit dem visuellen Kontext verknüpfen.
Semantisches Verstehen durch Modelle für natürliche Sprache unterstützen.
Visuelles Sprachverständnis und Wahrnehmungsalgorithmen verbinden, um Bildverständnis und Objekterkennung zu unterstützen.
Kontextverwaltung und Agent-Laufzeit
Über das Laufzeitframework an unterschiedliche Plattformen anpassen.
Die Modellinferenz wird für einen effizienten Betrieb auf dem Gerät an die Rechenleistung des Chips und die Betriebsbedingungen angepasst.
Aufgabenkontext und Verlaufsinformationen verwalten und die Agent-Orchestrierung organisieren.
Benötigte Modelle und Funktionen über APIs, Container und Middleware anbinden.
Die Generierung von Komponenten, wechselnde Designs und Kombinationen von Oberflächen untersuchen.
Absichten analysieren, Aufgaben planen und Werkzeuge aufrufen
Mehrere Agenten werden anhand von Kontextinformationen und Aufgabenzielen koordiniert, um Aufgaben in Mobilitätsdiensten und Robotikanwendungen gemeinsam zu erfüllen.
Anforderungen und Einschränkungen über mehrere Dialogrunden zusammenführen.
Aufgabenschritte organisieren, Werkzeuge und Dienste nach Bedarf aufrufen und Ausführungsergebnisse aufnehmen.
Gemeinsam mit Partnerfähigkeiten das Verstehen von Oberflächen und zielgerichtete Bedienvorgänge untersuchen.
API-/MCP-Integration und Model-Service-Management
Cloud-Ressourcen und Geschäftsdienste anbinden, Laufzeitfeedback bündeln und kontinuierliche Verbesserungen unterstützen.
Cloud-Modelle und Wissensressourcen verwalten.
Geschäftsdienste über API / MCP anbinden.